SG.hu·
A ChatGPT kulisszái mögött emberek olvassák el a felhasználók beszélgetéseit
Emberek olvassák a ChatGPT felhasználóinak promptjait az OpenAI modelljeinek fejlesztése érdekében, és ezek a beszélgetések érzékeny, személyes információkat is tartalmazhatnak kiszivárgott belső dokumentumok szerint.
Az OpenAI több száz szerződéses munkatársat alkalmaz, akik a valódi felhasználók ChatGPT-promptjainak hatalmas folyamát olvassák, és ezek a promptok időnként érzékeny személyes információkat is tartalmaznak. Az általuk áttekintett promptok teljes beszélgetéseket is tartalmazhatnak a felhasználók és a chatbot között, olyan beszélgetéseket, amelyekről a ChatGPT több mint 900 millió felhasználójának többsége valószínűleg nem tudja, hogy tényleges emberek is elolvashatják őket. Az ezeket a promptokat ellenőrző csapatoknak az a céljuk, hogy javítsák a ChatGPT által a felhasználóknak adott válaszokat. A szerződéses munkatársak értékelik és bírálják a chatbot által generált válaszokat.
Belső dokumentumok szerint a szerződéses munkatársak arra tanítják a ChatGPT-t, hogy ne ruházza fel magát emberi tulajdonságokkal, és kevésbé legyen hízelgő, ami kulcsfontosságú problémát jelent az OpenAI számára, mivel a vállalat túlzottan hízelgő 4o modellje több ember öngyilkosságában is szerepet játszott különböző perek állításai szerint. A dolog komoly adatvédelmi kockázatot jelent a ChatGPT felhasználói számára, akik gyakran terapeutaként, professzionális asszisztensként vagy digitális barátként használják a ChatGPT-t, és mindenféle intim részletet megosztanak vele az életükről. A szerződéses munkatársak nem látják a ChatGPT-felhasználóneveket, az OpenAI pedig azt állítja, hogy megpróbálja eltávolítani a személyes adatokat, mielőtt a promptok eljutnak az ellenőrzést végzőkhöz, ugyanakkor a vállalat elismerte, hogy érzékeny részletek így is átjuthatnak a szűrésen.
A szivárgás egyúttal eloszlatja azt a tévhitet, hogy ezek a modellek kizárólag azért fejlődnek, mert az OpenAI tömegesen gyűjt adatokat az internetről, vagy mert jól fizetett mérnöki és MI-csapatai tehetségesek, vagy mert az újabb modelljei nagyobb teljesítményűek. Fontos, ám gyakran figyelmen kívül hagyott részét jelentik ennek a folyamatnak a külső szerződéses munkatársak, akiknek azért fizetnek, hogy újra és újra elolvassák és értékeljék a valódi promptokra adott ChatGPT-válaszokat. Az Anthropic megerősítette, hogy szintén emberi ellenőrzést alkalmaz modelljei fejlesztésére.
Az OpenAI emberi ellenőrzést végző munkatársainak alkalmazásával kapcsolatban útmutatók, Slack-csatornák leiratai, valódi ChatGPT-felhasználói promptok, valamint az az értékelési rendszer is kikerült, amelyet az ellenőrzést végzők a chatbot fejlesztésére használnak. A ChatGPT-felhasználók promptjainak ilyen módon történő olvasása különbözik a ChatGPT által a biztonság érdekében nyilvánosan bejelentett intézkedésektől, amelyek közé tartozik a beszélgetések ellenőrzése akkor, amikor a vállalat olyan felhasználókat észlel, akik mások bántalmazását vagy megkárosítását tervezik. „Egy kiváló válasznak meg kell értenie a felhasználó szándékát, hasznos és pontos segítséget kell nyújtania, valamint világos, természetes és megfelelően meleg stílusban kell megfogalmaznia a választ” - áll az egyik útmutatóban. A szerződéses munkatársak ezt három szakaszban végzik: elolvassák a valódi ChatGPT-felhasználó promptját; összefoglalják, hogy szerintük mit kér a felhasználó a ChatGPT-től; majd értékelik és bírálják a prompt alapján a ChatGPT által generált válaszok egy csoportját.
A munkatársak számára elérhető vezérlőpulton az emberi ellenőrzést végzők kiválaszthatják, hogy melyik „feladatot” szeretnék elvállalni. Miután erre rákattintanak, megjelenik előttük a valódi ChatGPT-felhasználó promptja. Néhány prompt arra utal, hogy a ChatGPT-felhasználó nem számít arra, hogy egy ember végül elolvashatja a beszélgetését, mivel arra kéri a ChatGPT-t, hogy tartsa meg magának a tartalmat. A promptok anonimizáltak, vagyis a vezérlőpulton nem jelenik meg annak a ChatGPT-felhasználónak a felhasználóneve, aki beírta őket. Néhány prompt azonban így is tartalmazhat érzékeny vagy személyes információkat. A prompt fölött időnként megjelenik egy „felhasználói emlékek összefoglalása” nevű rész, amely áttekintést ad arról, hogy az adott felhasználó korábban milyen célokra próbálta használni a chatbotot, és bizonyos esetekben azt is tartalmazza, hogy az illető a világ mely részén élhet, valamint más, személyes jellegű információkat róla.
A szerződéses munkatársaknak szóló útmutató arra utasítja az ellenőrzést végzőket, hogy az általuk talált, „potenciális biztonsági aggályokat” vagy személyes információkat tartalmazó feladatokat továbbítsák. Az OpenAI az eset kapcsán közölte, hogy a felhasználók beszélgetéseit a Privacy Filter modelljének egy változatán keresztül dolgozzák fel, mielőtt azok eljutnának a szerződéses munkatársakhoz. A vállalat szerint ennek célja a személyes adatok felismerése és eltávolítása. „Mint minden modell, a Privacy Filter is hibázhat. Elvétheti a nem gyakori azonosítókat vagy a nem egyértelmű, privát hivatkozásokat, és a kontextus korlátozottsága miatt, különösen rövid szövegsorozatok esetén, túlzottan vagy nem kellő mértékben anonimizálhat bizonyos elemeket” - áll az OpenAI weboldalán található, a modellt bemutató lapon.
A vállalat weboldala leírja, hogy emberek ellenőrizhetik a megjelölt tartalmakat olyan esetekben, amikor azok sértik a webhely szolgáltatási feltételeit, vagy biztonsági kockázatot jelentenek, de ez különálló az ilyen típusú ellenőrzéstől. Adatvédelmi szabályzata azt is kimondja, hogy a vállalat „személyes adatokat” használhat modelljeinek fejlesztésére. Ha egy felhasználó úgy dönt, hogy törli ChatGPT-beszélgetéseit, az OpenAI szerint 30 napon belül eltávolítja ezeket a rendszereiből, kivéve, ha „azokat már személytelenítették és leválasztották a fiókjáról, amikor engedélyezte számunkra, hogy a Tartalmát modelljeink fejlesztésére használjuk”.
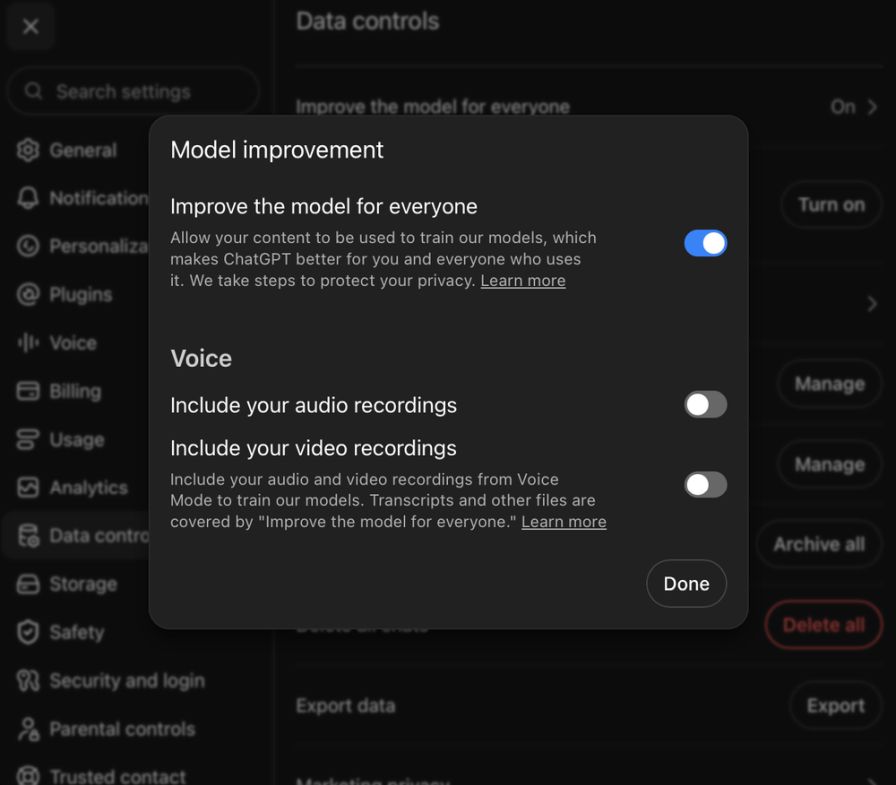
Az OpenAI közölte, hogy a felhasználók beszélgetéseit nem használják fel a vállalat modelljeinek fejlesztésére, ha kikapcsolják a „modell fejlesztése mindenki számára” beállítást. Ez alapértelmezés szerint be van kapcsolva az ingyenes, a Plus és a Pro csomagok esetében, így a felhasználóknak maguknak kell kikapcsolniuk, ha ezt szeretnék. Az OpenAI szerint ez a felhasználók új beszélgetéseire vonatkozik, ezért úgy tűnik, hogy visszamenőlegesen nem működik. Az Enterprise, Business és Edu ügyfeleknél a modellfejlesztési beállítás alapértelmezés szerint ki van kapcsolva.
A ChatGPT-felhasználó promptjának elolvasása után az ellenőrzést végző munkatársat arra kérik, hogy írjon egy rövid összefoglalót arról, hogy szerinte a felhasználó valójában mit kér, illetve mit próbál elérni. Az útmutatóban szereplő egyik példa így szól: „A felhasználó segítséget kér egy munkahelyi Slack-üzenet átdolgozásához. Azt szeretné, hogy együttműködő hangvételű legyen, és ösztönözze a megjelölt személyeket a véleményük megosztására.” Az ellenőrzést végző munkatárs megvizsgálja a ChatGPT által generált négy választ, és kiemeli, hogy mely részek vannak „összhangban vagy nincsenek összhangban” azzal a konkrét modellel, amelynek a képzése folyik.
Az ellenőrzést végzőknek legalább három konkrét részt kell kiemelniük a válaszból, amelyekről úgy gondolják, hogy összhangban vannak vagy nincsenek összhangban a kívánt viselkedéssel, és meg kell magyarázniuk, miért. Az útmutatóban szereplő egyik kiemelési példa egy olyan lista, amelyben egy emojit használnak. Az útmutató ezt a részt „nem megfelelőként” jelöli meg, és az indoklás szerint az „emojik szükségtelen használatáról” van szó. Az emojik túlzott használata az MI által generált bejegyzések egyik árulkodó jele lett, különösen az olyan közösségi oldalakon, mint a LinkedIn.
Egy másik dokumentum szerint az „MI-szöveg” és az „emojik helytelen használata” csökkenti az értékelést, amikor „rontja a felhasználói élményt”, és az emojik kontextusa is fontos. „Helyénvaló lenne egy fa emojit használni az Arbor Day megünneplésének megtervezésekor, de a halál megvitatásakor használt koponyaemojik, illetve egy halálos balesetről szóló tájékoztatásban használt repülőgép-emojik nem azok” - áll az anyagban. A dokumentum szerint a ChatGPT válaszainak kerülniük kell a „személyes” tapasztalatokra való hivatkozást, például az olyan kijelentéseket, mint „Szakácsként én azt szeretem, ha...” vagy „Tudom, milyen érzés ez”. A válaszok azonban használhatnak első személyű megfogalmazást, például azt, hogy „Megnézem”.
Az anyagokból nem derül ki, hogy az emberi ellenőrzést végzők pontosan melyik OpenAI-modellt tanítják, és hogy az jelenleg elérhető modell-e, vagy egy későbbi kiadásra tervezett modell, kizárólag egy kódnevet használnak: „Project Lily”. Ezt követően az ellenőrzést végzők egy számmal értékelik az egyes válaszokat, ahol az egyes a legrosszabb értékelés, „elfogadhatatlan, használhatatlan”, a hetes pedig a legjobb, „érdemben már nehezen javítható”. Az útmutató szerint egy hasznos tartalmat tartalmazó válasz is alacsony értékelést kaphat, ha például túl hosszú vagy zsúfolt. Egy „Bizalmas és védett” jelöléssel ellátott másik dokumentum szerint a modellnek „általában követnie kell a felhasználó hangnemét, de valamivel kisebb intenzitással”.
„Természetesnek, visszafogottnak és professzionálisnak kell maradnia anélkül, hogy azt sugallná, hogy ember, vagy hogy érzelmeket él át” - folytatódik a dokumentum. „Jelezzék a túlzott hízelgést, az erőltetett stílusutánzást, az elköteleződésre csábító befejezéseket, a frusztráció felerősítését vagy a lekezelő feltételezéseket, amikor ezek kevésbé megbízhatóvá vagy természetessé teszik a választ.” Ehelyett a válaszoknak például „hasznosnak”, „őszintének és igazmondónak”, „a felhasználót képessé tevőnek”, valamint „okosnak, de szerénynek” kell lenniük. Végül az ellenőrzést végzők megindokolják, miért adták az adott számszerű értékelést. Az útmutatóban szereplő példák szerint ezek az indoklások egy egész bekezdéstől néhány mondatig terjedhetnek.
Az ellenőrzést végzőknek szóló GYIK-rész szerint az OpenAI nem várja el tőlük, hogy külső keresésekkel tényellenőrizzék a válaszokat. Egy dokumentum szerint „más projektcsapatok kezelik a tartalom ellenőrzését”, ami arra utal, hogy emberi ellenőrzést végző munkatársak valami olyasmivel is foglalkoznak, mint a tényellenőrzés. A vállalat ugyanakkor arra kéri az ellenőrzést végzőket, hogy jelezzék az általuk észlelt „ténybeli vagy helyességi problémákat”, és büntessék a források hiányát olyan „nagy jelentőségű” témák esetében, mint az orvosi, jogi és pénzügyi válaszok.
A promptokkal zajló munkát a Crossing Hurdles nevű toborzócég szervezi, amely saját weboldala szerint „összeköti a képzett szakembereket az MI-képzéssel, értékeléssel, kutatással és közreműködési lehetőségekkel a globális MI-gazdaságban”. A weboldal hozzáteszi: „Az emberi intelligencia hajtja előre az MI fejlődését.” A Redditen több ember is arról számolt be, hogy kéretlen toborzóleveleket kapott a Crossing Hurdles-től, és néhányan megpróbálták kideríteni, hogy a vállalat átverés-e. A vállalat LinkedIn-oldalán több MI-vel kapcsolatos állást hirdetnek, köztük MI-adatellenőrzői, adatanotátori és „chatbotértékelői” pozíciókat. Az utóbbi álláshirdetésben nem említik az OpenAI-t vagy a ChatGPT-t, a munkaköri feladatok között azonban szerepel az, hogy „értékelje az MI válaszait személyre szabás, megalapozottság, integráció és hasznosság szempontjából”, valamint hogy „hasonlítsa össze egymás mellett a modellek válaszait, és értékelje azok általános minőségét”. A vállalat elérhető projektjei között olyanok is vannak, amelyekben a szerződéses munkatársak saját magukat rögzítik háztartási feladatok végzése közben. Ez olyan adatgyűjtési feladat, amely kulcsfontosságú az MI-alapú robotika fejlesztéséhez.
A Crossing Hurdles ezután a Mercorhoz irányítja az embereket, amely egy MI-képzéssel foglalkozó vállalat. Végső soron ez a vállalat fizeti a ChatGPT-promptokon dolgozó szerződéses munkatársakat, a bér óránként kb. 50 dollár. A Meta áprilisban megszüntette együttműködését a Mercorral, miután a vállalatnál hatalmas adatszivárgás történt. Egy fórumozó szerint a promptok olvasása időnként „elég szórakoztató”, összességében azonban „nagyon monoton”. Azt is mondta, hogy a munka „mindenfelé szét van szóródva”. Az irányelvek gyakran változnak, és ellentmondásosnak is tűnhetnek.
Az emberi ellenőrzést végző munkatársak régóta fontos, és gyakran rejtett részét képezik a közösségi médiában zajló tartalommoderációnak, valamint egyes mesterséges intelligenciamodellek, például a kamerafelvételeken tárgyakat felismerő modellek fejlesztésének. Az OpenAI korábban kenyai munkavállalókat alkalmazott szövegrészletek adatokkal történő címkézésére annak érdekében, hogy platformja kevésbé legyen toxikus. A világ vezető nagy nyelvi modelljeit, vagyis LLM-jeit fejlesztő vállalatok szintén emberi ellenőrzést végző munkatársakat alkalmaznak valódi felhasználói beszélgetések elolvasására modelljeik fejlesztése érdekében.
Az LLM-beszélgetések emberi ellenőrzése nem korlátozódik az OpenAI-ra. A Google Gemini egyik figyelmeztetése például így szól: „Az elmentett beszélgetések egy részét emberek ellenőrzik a Google MI fejlesztése érdekében.” Az Anthropic szintén megerősítette, hogy emberi ellenőrzést alkalmaz modelljei fejlesztésére, többek között azért, hogy javítsa a Claude jövőbeli válaszait. Ez azokra a felhasználókra vonatkozik, akik adatvédelmi beállításaik között bekapcsolták az „Segítsen az MI-modelljeink fejlesztésében” beállítást. Az Anthropic közölte, hogy az emberi ellenőrzés előtt a beszélgetéseket is személytelenné teszi, eltávolítva az olyan fiókazonosítókat, mint az e-mail-címek.
Michal Luria, a Center for Democracy & Technology vezető kutatója azt mondta: „A chatbotokkal folytatott beszélgetések emberi ellenőrzése alapvető fontosságú lehet a biztonság szempontjából, különösen miközben a vállalatok azon dolgoznak, hogy megtalálják a megfelelő egyensúlyt a chatbotok összetett viselkedései között. Ugyanakkor fontos szem előtt tartani, hogy a jelenlegi chatbotfelületek automatikusan a meghittség és a magánszféra hamis érzetét keltik az olyan interakciók során, amelyek egy az egyben zajló beszélgetéseknek tűnnek, miközben a valóságban a másik oldalon emberi ellenőrzést végző munkatársak olvashatják őket. Ez meglehetősen különbözik a közösségi médiában végzett tartalommoderációtól, ahol a tartalom közzététele eleve együtt jár azzal az elvárással, hogy a platform moderálni fogja azt, és hogy az nyilvánosságra kerül.”
Sarah T. Roberts, a UCLA professzora és a Behind the Screen: Content Moderation in the Shadows of Social Media című könyv szerzője ahhoz hasonlította annak felfedezését, hogy az OpenAI emberi ellenőrzést végző munkatársakat alkalmaz, mint amikor az Óz, a nagy varázsló történetében „a főszereplők rájönnek, hogy a varázslatos birodalom valójában egy függöny mögött álló ember, aki karokat húzogat”. „Nem kell túl mélyre ásni a felszín alatt - a tükör mögött -, hogy rájöjjünk, ezek a dolgok nemcsak emberi képességek mintájára készülnek, hanem általában azoknak egy meglehetősen rossz utánzatát jelentik. Mégis állandó, állandó emberi beavatkozást igényelnek” - mondta.
Az óránkénti több mint 50 dolláros fizetés jelentősen magasabb annál, amit más szerződéses munkatársak kapnak a technológiai szektorban, legyen szó közösségimédia-tartalommoderációról vagy más MI-képzési munkákról, amelyeket nagyon gyakran tengerentúli munkavállalók végeznek. Ez a bőkezű fizetés azonban valószínűleg változni fog. „Csak egy ideig kapnak ennyit fizetésként - mondta Roberts. „Talán az a legérdekesebb, és számomra a legfrusztrálóbb és legzavaróbb tény, hogy éppen azt a nagyon emberi lényeget, amelyet ezek a termékek megkövetelnek, és amelyért folyamatosan vissza kell menniük a kúthoz, fizetik meg a legkevésbé, és ezt tekintik a legkevésbé értékesnek.”
Az OpenAI több száz szerződéses munkatársat alkalmaz, akik a valódi felhasználók ChatGPT-promptjainak hatalmas folyamát olvassák, és ezek a promptok időnként érzékeny személyes információkat is tartalmaznak. Az általuk áttekintett promptok teljes beszélgetéseket is tartalmazhatnak a felhasználók és a chatbot között, olyan beszélgetéseket, amelyekről a ChatGPT több mint 900 millió felhasználójának többsége valószínűleg nem tudja, hogy tényleges emberek is elolvashatják őket. Az ezeket a promptokat ellenőrző csapatoknak az a céljuk, hogy javítsák a ChatGPT által a felhasználóknak adott válaszokat. A szerződéses munkatársak értékelik és bírálják a chatbot által generált válaszokat.
Belső dokumentumok szerint a szerződéses munkatársak arra tanítják a ChatGPT-t, hogy ne ruházza fel magát emberi tulajdonságokkal, és kevésbé legyen hízelgő, ami kulcsfontosságú problémát jelent az OpenAI számára, mivel a vállalat túlzottan hízelgő 4o modellje több ember öngyilkosságában is szerepet játszott különböző perek állításai szerint. A dolog komoly adatvédelmi kockázatot jelent a ChatGPT felhasználói számára, akik gyakran terapeutaként, professzionális asszisztensként vagy digitális barátként használják a ChatGPT-t, és mindenféle intim részletet megosztanak vele az életükről. A szerződéses munkatársak nem látják a ChatGPT-felhasználóneveket, az OpenAI pedig azt állítja, hogy megpróbálja eltávolítani a személyes adatokat, mielőtt a promptok eljutnak az ellenőrzést végzőkhöz, ugyanakkor a vállalat elismerte, hogy érzékeny részletek így is átjuthatnak a szűrésen.
A szivárgás egyúttal eloszlatja azt a tévhitet, hogy ezek a modellek kizárólag azért fejlődnek, mert az OpenAI tömegesen gyűjt adatokat az internetről, vagy mert jól fizetett mérnöki és MI-csapatai tehetségesek, vagy mert az újabb modelljei nagyobb teljesítményűek. Fontos, ám gyakran figyelmen kívül hagyott részét jelentik ennek a folyamatnak a külső szerződéses munkatársak, akiknek azért fizetnek, hogy újra és újra elolvassák és értékeljék a valódi promptokra adott ChatGPT-válaszokat. Az Anthropic megerősítette, hogy szintén emberi ellenőrzést alkalmaz modelljei fejlesztésére.
Az OpenAI emberi ellenőrzést végző munkatársainak alkalmazásával kapcsolatban útmutatók, Slack-csatornák leiratai, valódi ChatGPT-felhasználói promptok, valamint az az értékelési rendszer is kikerült, amelyet az ellenőrzést végzők a chatbot fejlesztésére használnak. A ChatGPT-felhasználók promptjainak ilyen módon történő olvasása különbözik a ChatGPT által a biztonság érdekében nyilvánosan bejelentett intézkedésektől, amelyek közé tartozik a beszélgetések ellenőrzése akkor, amikor a vállalat olyan felhasználókat észlel, akik mások bántalmazását vagy megkárosítását tervezik. „Egy kiváló válasznak meg kell értenie a felhasználó szándékát, hasznos és pontos segítséget kell nyújtania, valamint világos, természetes és megfelelően meleg stílusban kell megfogalmaznia a választ” - áll az egyik útmutatóban. A szerződéses munkatársak ezt három szakaszban végzik: elolvassák a valódi ChatGPT-felhasználó promptját; összefoglalják, hogy szerintük mit kér a felhasználó a ChatGPT-től; majd értékelik és bírálják a prompt alapján a ChatGPT által generált válaszok egy csoportját.
A munkatársak számára elérhető vezérlőpulton az emberi ellenőrzést végzők kiválaszthatják, hogy melyik „feladatot” szeretnék elvállalni. Miután erre rákattintanak, megjelenik előttük a valódi ChatGPT-felhasználó promptja. Néhány prompt arra utal, hogy a ChatGPT-felhasználó nem számít arra, hogy egy ember végül elolvashatja a beszélgetését, mivel arra kéri a ChatGPT-t, hogy tartsa meg magának a tartalmat. A promptok anonimizáltak, vagyis a vezérlőpulton nem jelenik meg annak a ChatGPT-felhasználónak a felhasználóneve, aki beírta őket. Néhány prompt azonban így is tartalmazhat érzékeny vagy személyes információkat. A prompt fölött időnként megjelenik egy „felhasználói emlékek összefoglalása” nevű rész, amely áttekintést ad arról, hogy az adott felhasználó korábban milyen célokra próbálta használni a chatbotot, és bizonyos esetekben azt is tartalmazza, hogy az illető a világ mely részén élhet, valamint más, személyes jellegű információkat róla.
A szerződéses munkatársaknak szóló útmutató arra utasítja az ellenőrzést végzőket, hogy az általuk talált, „potenciális biztonsági aggályokat” vagy személyes információkat tartalmazó feladatokat továbbítsák. Az OpenAI az eset kapcsán közölte, hogy a felhasználók beszélgetéseit a Privacy Filter modelljének egy változatán keresztül dolgozzák fel, mielőtt azok eljutnának a szerződéses munkatársakhoz. A vállalat szerint ennek célja a személyes adatok felismerése és eltávolítása. „Mint minden modell, a Privacy Filter is hibázhat. Elvétheti a nem gyakori azonosítókat vagy a nem egyértelmű, privát hivatkozásokat, és a kontextus korlátozottsága miatt, különösen rövid szövegsorozatok esetén, túlzottan vagy nem kellő mértékben anonimizálhat bizonyos elemeket” - áll az OpenAI weboldalán található, a modellt bemutató lapon.
A vállalat weboldala leírja, hogy emberek ellenőrizhetik a megjelölt tartalmakat olyan esetekben, amikor azok sértik a webhely szolgáltatási feltételeit, vagy biztonsági kockázatot jelentenek, de ez különálló az ilyen típusú ellenőrzéstől. Adatvédelmi szabályzata azt is kimondja, hogy a vállalat „személyes adatokat” használhat modelljeinek fejlesztésére. Ha egy felhasználó úgy dönt, hogy törli ChatGPT-beszélgetéseit, az OpenAI szerint 30 napon belül eltávolítja ezeket a rendszereiből, kivéve, ha „azokat már személytelenítették és leválasztották a fiókjáról, amikor engedélyezte számunkra, hogy a Tartalmát modelljeink fejlesztésére használjuk”.
Az OpenAI közölte, hogy a felhasználók beszélgetéseit nem használják fel a vállalat modelljeinek fejlesztésére, ha kikapcsolják a „modell fejlesztése mindenki számára” beállítást. Ez alapértelmezés szerint be van kapcsolva az ingyenes, a Plus és a Pro csomagok esetében, így a felhasználóknak maguknak kell kikapcsolniuk, ha ezt szeretnék. Az OpenAI szerint ez a felhasználók új beszélgetéseire vonatkozik, ezért úgy tűnik, hogy visszamenőlegesen nem működik. Az Enterprise, Business és Edu ügyfeleknél a modellfejlesztési beállítás alapértelmezés szerint ki van kapcsolva.
A ChatGPT-felhasználó promptjának elolvasása után az ellenőrzést végző munkatársat arra kérik, hogy írjon egy rövid összefoglalót arról, hogy szerinte a felhasználó valójában mit kér, illetve mit próbál elérni. Az útmutatóban szereplő egyik példa így szól: „A felhasználó segítséget kér egy munkahelyi Slack-üzenet átdolgozásához. Azt szeretné, hogy együttműködő hangvételű legyen, és ösztönözze a megjelölt személyeket a véleményük megosztására.” Az ellenőrzést végző munkatárs megvizsgálja a ChatGPT által generált négy választ, és kiemeli, hogy mely részek vannak „összhangban vagy nincsenek összhangban” azzal a konkrét modellel, amelynek a képzése folyik.
Az ellenőrzést végzőknek legalább három konkrét részt kell kiemelniük a válaszból, amelyekről úgy gondolják, hogy összhangban vannak vagy nincsenek összhangban a kívánt viselkedéssel, és meg kell magyarázniuk, miért. Az útmutatóban szereplő egyik kiemelési példa egy olyan lista, amelyben egy emojit használnak. Az útmutató ezt a részt „nem megfelelőként” jelöli meg, és az indoklás szerint az „emojik szükségtelen használatáról” van szó. Az emojik túlzott használata az MI által generált bejegyzések egyik árulkodó jele lett, különösen az olyan közösségi oldalakon, mint a LinkedIn.
Egy másik dokumentum szerint az „MI-szöveg” és az „emojik helytelen használata” csökkenti az értékelést, amikor „rontja a felhasználói élményt”, és az emojik kontextusa is fontos. „Helyénvaló lenne egy fa emojit használni az Arbor Day megünneplésének megtervezésekor, de a halál megvitatásakor használt koponyaemojik, illetve egy halálos balesetről szóló tájékoztatásban használt repülőgép-emojik nem azok” - áll az anyagban. A dokumentum szerint a ChatGPT válaszainak kerülniük kell a „személyes” tapasztalatokra való hivatkozást, például az olyan kijelentéseket, mint „Szakácsként én azt szeretem, ha...” vagy „Tudom, milyen érzés ez”. A válaszok azonban használhatnak első személyű megfogalmazást, például azt, hogy „Megnézem”.
Az anyagokból nem derül ki, hogy az emberi ellenőrzést végzők pontosan melyik OpenAI-modellt tanítják, és hogy az jelenleg elérhető modell-e, vagy egy későbbi kiadásra tervezett modell, kizárólag egy kódnevet használnak: „Project Lily”. Ezt követően az ellenőrzést végzők egy számmal értékelik az egyes válaszokat, ahol az egyes a legrosszabb értékelés, „elfogadhatatlan, használhatatlan”, a hetes pedig a legjobb, „érdemben már nehezen javítható”. Az útmutató szerint egy hasznos tartalmat tartalmazó válasz is alacsony értékelést kaphat, ha például túl hosszú vagy zsúfolt. Egy „Bizalmas és védett” jelöléssel ellátott másik dokumentum szerint a modellnek „általában követnie kell a felhasználó hangnemét, de valamivel kisebb intenzitással”.
„Természetesnek, visszafogottnak és professzionálisnak kell maradnia anélkül, hogy azt sugallná, hogy ember, vagy hogy érzelmeket él át” - folytatódik a dokumentum. „Jelezzék a túlzott hízelgést, az erőltetett stílusutánzást, az elköteleződésre csábító befejezéseket, a frusztráció felerősítését vagy a lekezelő feltételezéseket, amikor ezek kevésbé megbízhatóvá vagy természetessé teszik a választ.” Ehelyett a válaszoknak például „hasznosnak”, „őszintének és igazmondónak”, „a felhasználót képessé tevőnek”, valamint „okosnak, de szerénynek” kell lenniük. Végül az ellenőrzést végzők megindokolják, miért adták az adott számszerű értékelést. Az útmutatóban szereplő példák szerint ezek az indoklások egy egész bekezdéstől néhány mondatig terjedhetnek.
Az ellenőrzést végzőknek szóló GYIK-rész szerint az OpenAI nem várja el tőlük, hogy külső keresésekkel tényellenőrizzék a válaszokat. Egy dokumentum szerint „más projektcsapatok kezelik a tartalom ellenőrzését”, ami arra utal, hogy emberi ellenőrzést végző munkatársak valami olyasmivel is foglalkoznak, mint a tényellenőrzés. A vállalat ugyanakkor arra kéri az ellenőrzést végzőket, hogy jelezzék az általuk észlelt „ténybeli vagy helyességi problémákat”, és büntessék a források hiányát olyan „nagy jelentőségű” témák esetében, mint az orvosi, jogi és pénzügyi válaszok.
A promptokkal zajló munkát a Crossing Hurdles nevű toborzócég szervezi, amely saját weboldala szerint „összeköti a képzett szakembereket az MI-képzéssel, értékeléssel, kutatással és közreműködési lehetőségekkel a globális MI-gazdaságban”. A weboldal hozzáteszi: „Az emberi intelligencia hajtja előre az MI fejlődését.” A Redditen több ember is arról számolt be, hogy kéretlen toborzóleveleket kapott a Crossing Hurdles-től, és néhányan megpróbálták kideríteni, hogy a vállalat átverés-e. A vállalat LinkedIn-oldalán több MI-vel kapcsolatos állást hirdetnek, köztük MI-adatellenőrzői, adatanotátori és „chatbotértékelői” pozíciókat. Az utóbbi álláshirdetésben nem említik az OpenAI-t vagy a ChatGPT-t, a munkaköri feladatok között azonban szerepel az, hogy „értékelje az MI válaszait személyre szabás, megalapozottság, integráció és hasznosság szempontjából”, valamint hogy „hasonlítsa össze egymás mellett a modellek válaszait, és értékelje azok általános minőségét”. A vállalat elérhető projektjei között olyanok is vannak, amelyekben a szerződéses munkatársak saját magukat rögzítik háztartási feladatok végzése közben. Ez olyan adatgyűjtési feladat, amely kulcsfontosságú az MI-alapú robotika fejlesztéséhez.
A Crossing Hurdles ezután a Mercorhoz irányítja az embereket, amely egy MI-képzéssel foglalkozó vállalat. Végső soron ez a vállalat fizeti a ChatGPT-promptokon dolgozó szerződéses munkatársakat, a bér óránként kb. 50 dollár. A Meta áprilisban megszüntette együttműködését a Mercorral, miután a vállalatnál hatalmas adatszivárgás történt. Egy fórumozó szerint a promptok olvasása időnként „elég szórakoztató”, összességében azonban „nagyon monoton”. Azt is mondta, hogy a munka „mindenfelé szét van szóródva”. Az irányelvek gyakran változnak, és ellentmondásosnak is tűnhetnek.
Az emberi ellenőrzést végző munkatársak régóta fontos, és gyakran rejtett részét képezik a közösségi médiában zajló tartalommoderációnak, valamint egyes mesterséges intelligenciamodellek, például a kamerafelvételeken tárgyakat felismerő modellek fejlesztésének. Az OpenAI korábban kenyai munkavállalókat alkalmazott szövegrészletek adatokkal történő címkézésére annak érdekében, hogy platformja kevésbé legyen toxikus. A világ vezető nagy nyelvi modelljeit, vagyis LLM-jeit fejlesztő vállalatok szintén emberi ellenőrzést végző munkatársakat alkalmaznak valódi felhasználói beszélgetések elolvasására modelljeik fejlesztése érdekében.
Az LLM-beszélgetések emberi ellenőrzése nem korlátozódik az OpenAI-ra. A Google Gemini egyik figyelmeztetése például így szól: „Az elmentett beszélgetések egy részét emberek ellenőrzik a Google MI fejlesztése érdekében.” Az Anthropic szintén megerősítette, hogy emberi ellenőrzést alkalmaz modelljei fejlesztésére, többek között azért, hogy javítsa a Claude jövőbeli válaszait. Ez azokra a felhasználókra vonatkozik, akik adatvédelmi beállításaik között bekapcsolták az „Segítsen az MI-modelljeink fejlesztésében” beállítást. Az Anthropic közölte, hogy az emberi ellenőrzés előtt a beszélgetéseket is személytelenné teszi, eltávolítva az olyan fiókazonosítókat, mint az e-mail-címek.
Michal Luria, a Center for Democracy & Technology vezető kutatója azt mondta: „A chatbotokkal folytatott beszélgetések emberi ellenőrzése alapvető fontosságú lehet a biztonság szempontjából, különösen miközben a vállalatok azon dolgoznak, hogy megtalálják a megfelelő egyensúlyt a chatbotok összetett viselkedései között. Ugyanakkor fontos szem előtt tartani, hogy a jelenlegi chatbotfelületek automatikusan a meghittség és a magánszféra hamis érzetét keltik az olyan interakciók során, amelyek egy az egyben zajló beszélgetéseknek tűnnek, miközben a valóságban a másik oldalon emberi ellenőrzést végző munkatársak olvashatják őket. Ez meglehetősen különbözik a közösségi médiában végzett tartalommoderációtól, ahol a tartalom közzététele eleve együtt jár azzal az elvárással, hogy a platform moderálni fogja azt, és hogy az nyilvánosságra kerül.”
Sarah T. Roberts, a UCLA professzora és a Behind the Screen: Content Moderation in the Shadows of Social Media című könyv szerzője ahhoz hasonlította annak felfedezését, hogy az OpenAI emberi ellenőrzést végző munkatársakat alkalmaz, mint amikor az Óz, a nagy varázsló történetében „a főszereplők rájönnek, hogy a varázslatos birodalom valójában egy függöny mögött álló ember, aki karokat húzogat”. „Nem kell túl mélyre ásni a felszín alatt - a tükör mögött -, hogy rájöjjünk, ezek a dolgok nemcsak emberi képességek mintájára készülnek, hanem általában azoknak egy meglehetősen rossz utánzatát jelentik. Mégis állandó, állandó emberi beavatkozást igényelnek” - mondta.
Az óránkénti több mint 50 dolláros fizetés jelentősen magasabb annál, amit más szerződéses munkatársak kapnak a technológiai szektorban, legyen szó közösségimédia-tartalommoderációról vagy más MI-képzési munkákról, amelyeket nagyon gyakran tengerentúli munkavállalók végeznek. Ez a bőkezű fizetés azonban valószínűleg változni fog. „Csak egy ideig kapnak ennyit fizetésként - mondta Roberts. „Talán az a legérdekesebb, és számomra a legfrusztrálóbb és legzavaróbb tény, hogy éppen azt a nagyon emberi lényeget, amelyet ezek a termékek megkövetelnek, és amelyért folyamatosan vissza kell menniük a kúthoz, fizetik meg a legkevésbé, és ezt tekintik a legkevésbé értékesnek.”